more >>睡吧,合上双眼,世界就与我无关。
——顾城,《生命幻想曲》
muduo 网络库日志后端
文前导读
muduo 网络库源码剖析系列的第二篇文章,主要着眼于 muduo 网络库中的日志系统后端的设计与实现
为了保证自己对 muduo 的代码有较为深入的理解,我自己写了一个 tmuduo 网络库,用来验证自己对 muduo 源码上的一些想法。
仓库地址为:git@github.com:Phoenix500526/Tmuduo.git,欢迎 fork、start 以及 follow,一起学习。
muduo 网络库日志前端
文前导读
muduo 网络库源码剖析系列的第一篇文章,主要着眼于 muduo 网络库中的日志系统前端的设计与实现
为了保证自己对 muduo 的代码有较为深入的理解,我自己写了一个 tmuduo 网络库,用来验证自己对 muduo 源码上的一些想法。
仓库地址为:git@github.com:Phoenix500526/Tmuduo.git,欢迎 fork、start 以及 follow,一起学习。
googletest测试框架初探
在 CMake 中使用 Google-Test
示例目录的源码树:
1 | $ tree |
测试通过:
1 | $ make test |
测试失败:
1 | $ make test |
具体的测试信息会保存在 build/Testing/Temporary/LastTest.log 文件
注1:googletest 也可以使用 clang 或 g++ 进行单独编译,编译命令为:
1 | $ clang++ UnitTest.cc -I ../google-test/googletest-src/googletest/include/ -L../google-test/googletest-build/googlemock/gtest -lgtest -lgtest_main -lpthread -std=c++11 -Wall |
注2:若测试时需要有配置文件,例如一个 ConfigUnittest.cc 会读取一个测试专用的配置文件:Config_unittest.ini 时,可以在对应目录下的 CMakeLists.txt 文件中添加
1 | # Config_unitest |
注3:若希望将拷贝形式变成执行 make copy_ini_file 的形式,则可以采用下面的 cmake 命令
1 | add_custom_target(copy_ini_file) |
3rd_party/google-test/CmakeLists.txt.in 文件
1 | cmake_minimum_required(VERSION 3.0) |
3rd_party/google-test/CmakeLists.txt 文件
1 | # Download and unpack googletest at configure time |
CMakeLists.txt 文件
1 | cmake_minimum_required(VERSION 3.5) |
CMakeLists.txt 编写总结:
最低版本要求 + 项目信息
将要测试的代码打包成待测库文件
执行 add_subdirectory 下载并构建 Google Test
打开测试开关
添加测试文件 unit_tests.cpp 为可执行目标 unit_tests
将 unit_tests 和待测库文件,以及 Google Test 的库文件链接到一起
执行 add_test 运行测试程序
unit_tests.cpp
1 |
|
googletest 的基本知识
注意:由于历史原因,googletest 中所提到的部分术语和常规软件工程中的术语不同,以下有一张对应表格
| googletest 中的术语 | 常规软件工程中所使用的术语 | 备注信息 |
|---|---|---|
| Test Case | Test Suited(测试套件) | 由一个或多个测试用例所构成的测试 |
| Test | Test Cas(测试用例) | 单个的测试代码 |
断言
- Fatal Assertion (ASSERT_*):一旦测试不通过,立即终止测试,并返回测试信息
- Nonfatal Assertion(EXCEPT_*):一旦测试不通过,报告测试信息,并接着执行下一个测试
| Fatal assertion | Nonfatal assertion | Verifies |
|---|---|---|
ASSERT_TRUE(condition); |
EXPECT_TRUE(condition); |
condition is true |
ASSERT_FALSE(condition); |
EXPECT_FALSE(condition); |
condition is false |
ASSERT_EQ(val1, val2); |
EXPECT_EQ(val1, val2); |
val1 == val2 |
ASSERT_NE(val1, val2); |
EXPECT_NE(val1, val2); |
val1 != val2 |
ASSERT_LT(val1, val2); |
EXPECT_LT(val1, val2); |
val1 < val2 |
ASSERT_LE(val1, val2); |
EXPECT_LE(val1, val2); |
val1 <= val2 |
ASSERT_GT(val1, val2); |
EXPECT_GT(val1, val2); |
val1 > val2 |
ASSERT_GE(val1, val2); |
EXPECT_GE(val1, val2); |
val1 >= val2 |
ASSERT_STREQ(str1,str2); |
EXPECT_STREQ(str1,str2); |
the two C strings have the same content |
ASSERT_STRNE(str1,str2); |
EXPECT_STRNE(str1,str2); |
the two C strings have different contents |
ASSERT_STRCASEEQ(str1,str2); |
EXPECT_STRCASEEQ(str1,str2); |
the two C strings have the same content, ignoring case |
ASSERT_STRCASENE(str1,str2); |
EXPECT_STRCASENE(str1,str2); |
the two C strings have different contents, ignoring case |
示例代码:
1 | // 可在测试断言后用 << 运算符打印自己的信息 |
注意事项:
若 val1 和 val2 是用户自定义类型,则必须重载相应的二元运算符以支持对应的比较操作。由于 Google C++ Style 规定禁止重载运算符,因此只能使用如 ASSERT_TRUE( val1 < val2) 这样的形式
在一般情况下更倾向于使用 ASSERT_EQ(actual, expected) ,而不是 ASSERT_TRUE(actual == expected)。这主要是因为当测试失败时,前者能够返回更多的信息(actual 和 expected 在实际测试中的值)
ASSERT_EQ() 用于判断两个指针是否相等时,只会判断这两个指针变量在内存中的位置是否相同,而并不会比较两个指针所指向的内容是否相同。要比较两个 C 风格的字符串字面值是否相等,应该采用 ASSERT_STREQ()。对于 string 对象则没有这个限制,依然可以使用 ASSERT_EQ
在判断一个 C 风格的指针是否为空或不为空时,使用 *_EQ(c_str, nullptr) 或者 *_NE(c_str, nullptr)。这是因为
nullptr是一种类型,而NULL不是。而且NULL指针和空的 string 对象是不同的。
Test 的创建
一个简单的示例:
1 | // Tests factorial of 0. |
在上述的例子中,使用了宏 Test(TestSuitName, TestName) 来定义和命名一个测试函数(无返回值)。TestSuitName 代表测试套件的名称,而 TestName 则代表单个测试的名称。由于测试结果会按照测试套件名称进行分组,因此逻辑上相关的测试最好集中到同一个测试套件当中。另外,不同的测试套件中的同名测试互不影响。TestSuitName 和 TestName 中不能带有 ‘_’ 字符
测试夹具(Test Fixture)【测试夹具可以为多个测试提供相同的数据配置】
一个简单的示例:
1 | //待测试的源文件 |
通过例子可以看出,使用测试夹具的基本流程如下:
- 从 ::testing::Test 派生一个测试夹具类(通常命名为 类名+Test)
- 在夹具类中定义稍后测试所需要使用的对象。注意测试夹具类中的成员均采用 protected 作为访问限定符,以便夹具类的子类也可以访问这些成员。
- 必要的情况下,编写构造函数或 SetUp 函数来进行夹具对象的初始化,并编写析构函数或 TearDown 函数来进行回收资源的工作
- 若有必要,为测试定义子例程
在执行上述测试代码的过程中,会发生以下情况:
- googletest 会创建一个 QueueTest 对象 t1
- 对 t1 执行 SetUp() 进行初始化
- 在 t1 上运行第一个测试 IsEmptyInitially
- 对 t1 执行 TearDown() 函数
- 创建一个 QueueTest 对象 t2
- 对 t2 对象执行 SetUp() 函数
- 在 t2 上运行第二个测试 DequeueWorks
- 对 t2 对象执行 TearDown() 函数
什么时候使用构造/析构函数,什么时候又应当使用 SetUp/TearDown 函数 ?
使用构造/析构函数的好处:
- 在创建 test fixture 对象的时候,可以将其设置为 const,从而避免意外修改到对象当中的数据
- 能够确保 test fixture 对象的派生对象在构造的时候优先构造基类子对象,析构的时候最后析构基类子对象
使用 SetUp / TearDwon 的优点:
C++ 在构造函数中无法使用多态。因此在需要使用多态进行构造的场合,你只能使用 SetUp 和 TearDown 函数
C++ 构造 / 析构函数的函数体中无法使用 ASSERT_* 断言
如果 TearDown 的操作可能会抛出异常,那么只能使用 TearDown 的方式
在 main 中调用测试
一个简单的示例:
1 |
|
在上述的例子当中,googletest 会自动将创建好的测试套件以及测试夹具中的测试注册起来,并通过 RUN_ALL_TESTS()来调用所有的测试。对于 RUN_ALL_TESTS() 有以下两点注意事项:
- 不要忽略
RUN_ALL_TESTS()的返回值, 0 代表通过, 1 则代表失败。对于 main 函数而言,如果没有返回RUN_ALL_TESTS()的返回值会导致编译错误 -
RUN_ALL_TESTS()只能调用一次。调用两次或以上的RUN_ALL_TESTS()和 googletest 的一些其他特性相冲突,因此并不被支持。 - 在调用
RUN_ALL_TESTS()之前需要调用::testing::InitGoogleTest(&argc, argv);以正确解析命令行参数。这可以使得用户能够通过命令行来控制测试程序的行为
googletest 提供了一个默认的 main 函数,如果你不需要在 main 函数中完成什么定制化的操作,则可以直接将测试程序连接到 gtest_main 当中即可。
Leetcode 493. 翻转对(归并排序+二分查找)
问题描述
给定一个数组 nums ,如果 i < j 且 nums[i] > 2*nums[j] 我们就将 (i, j) 称作一个重要翻转对。
你需要返回给定数组中的重要翻转对的数量。
Example
示例 1:
输入: [1,3,2,3,1]
输出: 2
示例 2:
输入: [2,4,3,5,1]
输出: 3
题目链接: 493. 翻转对(难度:困难)
思路
这道题可以采用归并排序 + 二分查找来解决。我们可以先考虑一个最简单的情况,如 [-10, -6],我们可以先将 [-10, -10] 分割为 L 和 R 两个子数组,其中 L = [-10], R = [-6]。显然,L 和 R 中都只有一个元素,本身就是有序数组,同时翻转对数为0。将 L 和 R 合并排序,由于 L[0] > 2 * R[0], 得到排序后的数组为 [-10, -6], 且翻转对数为 1。
上述过程大体上描绘了代码主体的框架,要求出一个数组的翻转对数,我们需要将其划分为 L 和 R,并求出 L 和 R 中的翻转对数 v1 和 v2,然后对排好序的 L 和 R 进行合并排序,得到翻转对数 v3,则数组本身的翻转对数就是 v1 + v2 + v3。
这道题有两个值得注意的细节:
- 在对 L 和 R 进行合并排序的过程中,由于 L 和 R 都是有序数组,因此可以使用二分查找来优化
- 由于可能存在负数,因此可能会出现 L[i] < R[j], 但 L[i] > 2 * R[j] 的情况,对于这种情况,需要从头扫描整个数组,因为 L[i] 前面的元素也可能大于 2 * R[j]。若为正数,则直接扫描 L[i, end) 即可,因为L[i] 前面的元素小于 L[i],而 L[i] < 2 * R[j], 所以 L[i] 前面的元素也都不需要考虑了
代码
1 | class Solution { |
运行结果:456ms, 42 MB
相关练习:
剑指 Offer 51. 数组中的逆序对(难度:困难)
315. 计算右侧小于当前元素的个数(难度:困难)
Libevent 源码阅读笔记(三)、日志系统的实现
Libevent 如何定义自己的日志输出格式
Libevent 的日志系统中定义了四个日志的输出等级,默认情况下会将日志信息输出到终端。不过 Libevent 允许用户设置自定义的日志输出回调函数以及异常日志输出函数,以提供日志信息的进一步解释和输出重定向。回调函数的指针定义如下:
1 | //event.h |
Libevent 默认将这两个回调函数置为 NULL,用户可以通过函数event_set_log_callback和event_set_fatal_callback进行设置
1 | //log.c |
若用户没有自定义日志输出函数,那么 Libevent 会根据 severity 的值调用相应的默认日志输出函数,并向 stderr 输出日志信息。具体的实现如下:
1 | //log.c |
日志系统的底层函数
看完了 Libevent 的日志系统留给用户的两个接口定义后,我们可以来看看 Libevent 默认的日志输出函数。在源码当中,日志系统相关的文件主要有两个: log.c 和 log-internal.h。我们先来看 log-internal.h 文件
1 | // log-internal.h |
在 log-internal.h 中,我们可以看到 Libevent 中的日志系统其实运用到了编译器属性 attribute 的一些技巧。
attribute 是 GNU C 下的一种机制,可以用来设置函数属性、变量属性以及类型属性,它的语法格式如下
1 | __attribute__((attribute-list)) |
其中 attribute-list 是用逗号分隔开的列表。在 Libevent 的日志系统中,主要应用到的有以下三种 attribute 属性:
1. attribute((format(archetype, string-index, first-to-check)))
该属性可以为函数添加上类似于 print、scanf、strftime 以及 strfmon 风格的格式化字符串,从而可以帮助我们完成对格式化字符串的类型检查。其中,archetype 代表参数的格式化风格,string-index 代表格式化字符串位于形参列表中的哪个位置,first-to-check 代表可变参数列表在形参列表中的哪个位置。结合一个 event_warn 的例子:
void event_warn(const char *fmt, …) attribute((format(printf, 1, 2)));
attribute((format(printf, 1, 2))) 代表按照 printf 的风格检查格式化字符串,其中参数列表的第 1 个参数代表格式化字符串,第 2 个参数代表可变参数列表。
2. attribute((noreturn))
noreturn 是一个函数属性,用来通知编译器该函数在执行后不会将控制权返回给它的调用者。以函数 event_err为例,当程序使用该日志函数时,说明程序已然产生了严重的错误,不能再继续执行下去,除了抛出异常,或者调用如exit()或abort()函数终止程序以外,可以利用 noreturn 来处理。当函数执行 event_err 时,主程序会将控制权交给 event_err 函数,当 event_err 执行完毕后,控制流将不会返回主程序,而是停留在此处。
3. attribute ((visibility(“default”)))
visibility属性可以将从动态库中导出可见符号,default 代表可见,而 hidden 代表隐藏。新版本的 Linux 内核限制了动态库的符号可见性,因为这样做可以提高程序的模块性,同时动态库装载和识别的符号越少,程序启动和运行的速度也就越快。Libevent 中被 EVENT2_EXPORT_SYMBOL 修饰的函数符号都将会被导出,因此使用该动态库程序都可以使用到这些函数。
对于event_err,event_sock_err,event_debugx_等函数,它们的实现大同小异,区别仅是部分参数的不同,以下选取部分函数进行讨论
1 | void event_err(int eval, const char *fmt, ...) |
上述的日志函数大体的结构是相同的,都采用了可变参数列表的形式实现,最终通过event_logv_以及event_log两个函数将日志输出。
一些语法糖
在 log-internal.h 当中还定义了一个 event_debug 的宏,可以用于在调试期间打印出调试信息。利用这个宏来代替event_debugx_函数,一方面可以使得调试语义更加清晰,另一方面也可以非常方便地实现调试模式的开关。它的定义如下:
1 |
总结
- Libevent 的日志系统为用户提供了两个接口
event_log_cb和event_fatal_cb,以便用户实现自定义的日志处理功能,在需要的时候可以使用event_set_log_callback和event_set_fatal_callback进行设置 - 如果用户没有定义自己的日志处理回调函数,则采用 Libevent 默认的日志处理系统,它将日志输出等级定义为四个,并会将日志输出到终端。
- 在日志系统的开发过程当中,利用好 GNU C 的一些机制,如 attribute 等,可以极大简化一些繁琐的检查过程,不仅有利于调试,帮助找到一些难以发现的错误,还有助于编译器进行优化。
Libevent 源码阅读笔记(二)、从一个简单例子开始(下)
阅读本文之前请确保你看过上一篇文章:Libevent 源码阅读笔记(一)、从一个简单例子开始(上)
在上一篇文章中,我们提到了关于 Libevent 使用的一个基本逻辑:
- 调用
event_init()创建 event_base 对象,一个 event_base 对象相当于一个 Reactor 实例- 创建具体的事件处理器,其中
evsignal_new()创建的是信号事件处理器和evtimer_new()创建的是定时事件处理器- 调用
event_add()将事件处理器插入到注册事件队列中,并将其对应的事件插入到事件多路分发器中,相当于 Reactor 中的register_handler方法- 调用
event_base_dispatch()执行事件循环- 循环结束后,调用
*_free()释放系统资源
在这篇文章中,我们将继续分析剩余的后 3 个步骤
将事件处理器添加到注册事件队列中
要了解如何将事件处理器插入到注册事件队列中,就需要先知道 Libevent 是如何将句柄和注册事件之间的联系定义出来。其相关的数据结构主要定义在 event-internal.h 和 evmap.c 文件中
1 | //event-internal.h |
创建好的 event 事件可以利用 event_add()插入相应的注册事件队列中
1 | //向注册事件队列中添加事件处理器 |
可以看到,在整个 event_add_nolock_函数中,主要的工作是为不同的事件提供对应的操作,主要分为 3 类操作,
- 调用
evmap_io_add_将 I/O 事件添加到事件多路分发器中,并将对应的事件处理器添加到 I/O 事件队列当中,同时建立起 I/O 事件和 I/O 事件处理器之间的映射,最后将 I/O 事件处理器插入到注册事件队列中 - 调用
evmap_signal_add_将信号事件添加到事件多路分发器中,并将对应的事件处理器添加到信号事件队列当中,同时建立起信号事件和信号事件处理器之间的映射,最后将信号事件处理器插入到注册事件队列中 - 调用
event_queue_insert_inserted修改 event_base 的事件处理器总数 - 根据是否允许将定时器重新插入到通用定时器队列或时间堆中,调用
event_queue_reinsert_timeout和event_queue_insert_timeout来将定时器插入到通用定时器队列或时间堆中
接下来,对于注册事件,Libevent 通过evmap_io_add_、 evmap_signal_add_ 以及 event_queue_insert_inserted进行将它们插入到对应的事件队列当中,其中evmap_io_add_、 evmap_signal_add_ 被定义在 evmap.c 文件中,而event_queue_insert_inserted被定义在 event.c 文件中
1 | // evmap.c 文件 |
对于超时事件,Libevent 则调用了event_queue_insert_timeout来将定时器插入到通用定时器队列或时间堆。
1 | static void event_queue_insert_timeout(struct event_base *base, struct event *ev) |
这里需要指出,早期的 Libevent 使用了时间堆来设计定时器。由于在某些场合下,升序定时器链表的效率会更高,因此新版本的 Libevent 同时支持通用定时器链表和时间堆的操作。
Libevent 的核心动力 —— 事件循环
正如前面提到,Libevent 是基于事件驱动的,整个框架库的运转核心在于事件驱动:Reactor 在接收到相应事件后,通过 event_base_dispatch() 的方法,将事件分派给对应的事件处理器去处理。event_base_dispatch()定义在 event.c 文件中
1 | int event_base_dispatch(struct event_base *event_base) |
从代码中可以看出,event_base_dispatch()调用了event_base_loop(),而event_base_loop()的关键是
调用了 event_base 中的evsel->dispatch(),该方法封装了 I/O 复用系统调用。至于如何根据编程环境的不同,自动选择合适的 I/O 复用技术,可以看上一篇文章中关于 eventop 的介绍
释放资源
1 | static int event_base_free_queues_(struct event_base *base, int run_finalizers) |
参考资料
《Linux 高性能服务器编程》 —— 游双著
《libevent-book》 —— Libevent 上的官方文档
Libevent 源码阅读笔记(一)、从一个简单例子开始(上)
什么是 Libevent
Libevent 是一款基于 Reactor 模式实现,由事件驱动的高性能开源 I/O 框架库,它提供一组 API 并允许开发者为事件注册回调函数。当事件发生时,Libevent 实例会执行相应的回调函数。使用 Libevent 来实现网络服务器的事件循环检查框架,可以使开发者更加集中于程序的逻辑之上,减少了工作量,而且 Libevent 在稳定性,性能及可移植性方面有着出色的表现。基于 Libevent 框架库实现的著名软件有:高性能分布式的内存缓存软件 memcached 和 Google 浏览器的 Chromium 的 Linux 版本。
一个基于 Reactor 模式实现的 I/O 框架库大致上应当包含如下几个组件:
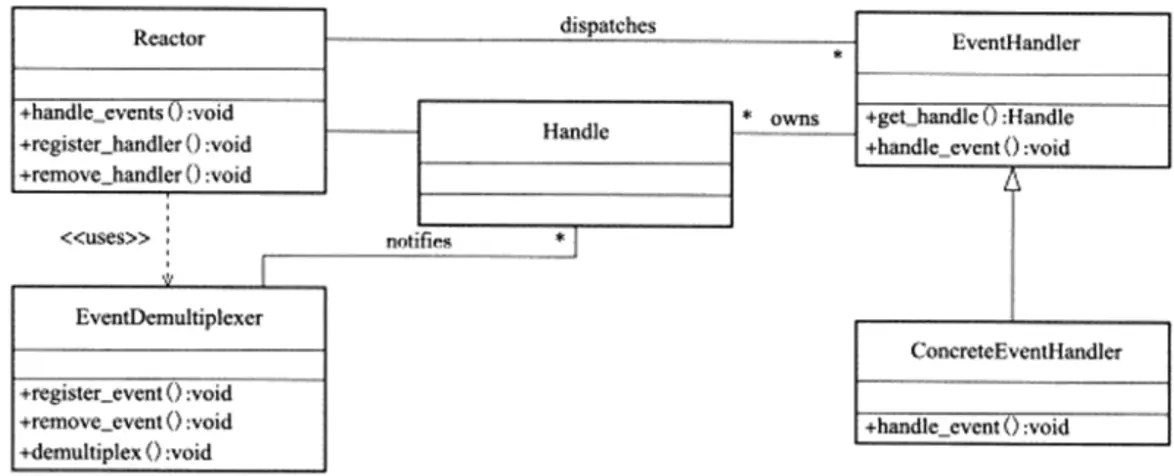
I/O 框架库组件
- 句柄(Handle):一个句柄通常代表了一个事件源,在 Linux 下, I/O 事件对应的句柄是文件描述符(fd),而信号事件对应的句柄是信号值
- 事件多路分发器(EventDemultiplexer):将系统支持的各种 I/O 复用的系统调用封装成统一的接口,称为事件多路分发器。一般包含了事件注册
register_event(),事件删除remove_event()和事件等待demultiplex()。其中demultiplex()是等待事件的核心函数,其内部调用的是select、poll、epoll_wait 等函数 - 事件处理器和具体事件处理器(EventHandler 和 ConcreteEventHandler):事件处理器是一个接口,其中包含了一个或多个
handle_event()方法。用户需要继承这一接口,并实现自己的事件处理器。 - Reactor:整个 I/O 框架库的核心,主要提供了以下几个方法:
-
handle_events():该方法执行事件循环,不断地等待事件,然后依次处理所有就绪事件对应的事件处理器 -
register_handler():调用事件多路分发器的register_event()方法来向事件多路分发器中注册一个事件 -
remove_handler():调用事件多路分发器的remove_event()方法来删除事件多路分发器中的一个事件
-
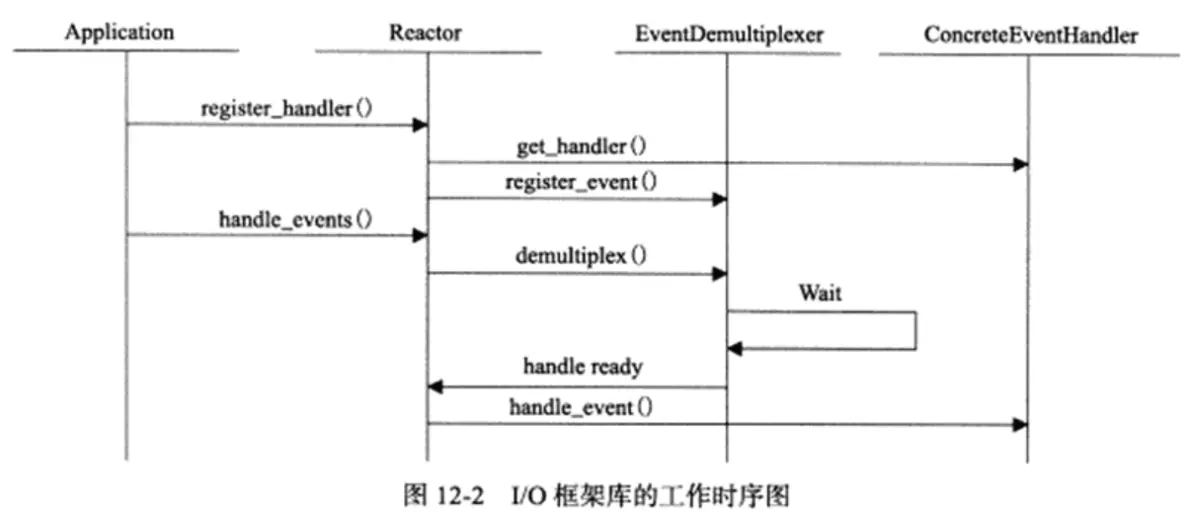
I/O 框架库的工作时序
Libevent 的源码链接:git clone https://github.com/libevent/libevent.git
Libevent 官网: http://libevent.org/
编译及安装方法(在 libevent 的源码目录下):
./configure
make
make verify # (optional)
sudo make install
一个简单的 libevent 示例代码:
1 | //helloworld.cpp |
编译方法:
g++ helloworld.cpp -levent_core -std=c++11
在上述的 Demo 中,包含了使用 Libevent 库的一个基本逻辑:
- 调用
event_init()创建 event_base 对象,一个 event_base 对象相当于一个 Reactor 实例- 创建具体的事件处理器,其中
evsignal_new()创建的是信号事件处理器和evtimer_new()创建的是定时事件处理器- 调用
event_add()将事件处理器插入到注册事件队列中,并将其对应的事件插入到事件多路分发器中,相当于 Reactor 中的register_handler方法- 调用
event_base_dispatch()执行事件循环- 循环结束后,调用
*_free()释放系统资源
接下来我们便按照上述 5 个步骤进行源码分析,出于篇幅考虑,会将这 5 个步骤拆分成 2 篇文章分别叙述,本篇只讨论前 2 个步骤。
event_init 函数的实现与相关的数据结构
在了解 event_int()函数做了何种操作之前,我们需要了解 event_base、eventop 这两个数据结构,它们都定义在 libevent-2.1.12-stable/event-internal.h 中。其中 event_base 构成了 Reactor 的角色, 而 eventop 则构成了 EventDemultiplexer 角色
1 | /** Structure to define the backend of a given event_base. */ |
正如先前所提到的那样,Libevent 向用户提供了统一的 I/O 复用接口,屏蔽了底层系统的之间的差异,而这一起都要通过定义在 event.c 文件中的 eventops 数组来实现。在不同的系统下有不同的优先级,对于 Linux 系统而言,默认使用的 I/O 复用技术是 epoll。
1 | //优先级 |
event_init()定义在 event.c 中,它的主要作用是执行 event_base_new_with_config(NULL)来创建一个 event_base 实例并将其保存在全局静态变量 current_base 当中。其中 ``event_base_new_with_config(NULL)`的参数为 NULL 代表根据程序的环境设置相应的 event_base 配置
1 | struct event_base *event_init(void) |
创建具体的事件处理器
在 Linux 服务器编程中,需要考虑的事件通常有三种:I/O 事件、信号以及定时器事件,而 Libevent 中采用了统一事件源的方式,将这三种事件利用 Unix 域套接字和 I/O 复用的系统调用统一转换成为 I/O 事件进行处理。统一对于信号和定时器,通过socketpair()创建一对 Unix 域套接字,这对套接字起到了一个全双工管道的作用,当信号或是超时事件发生时,通过管道将信号或超时事件发送至 Reactor 进行处理。
要了解 Libevent 的事件类型,我们需要了解位于 libevent-2.1.12-stable\include\event2\event_struct.h 中的 event 结构体和 event_callback 结构体。
1 | //TAILQ_ENTRY:尾队列中的节点类型 |
通过上述对 event 和 event_callback 的定义,我们对它们所起到的作用有了一定的了解。首先对于 event_callback 而言,它相当于一个 ConcreteEventHadler,其中主要的两个成员是 evcb_active_next,它指向了活动事件链表中的下一个节点,以及联合体成员 evcb_cb_union,它代表了某一个特定的回调函数。而对于 event 结构体而言,它相当于一个 EventHadler,其中主要的成员有具体的事件处理器 ev_evcallback、超时事件ev_timeout_pos、注册事件 ev_(其中包含了 I/O 事件 ev_io 和信号事件 ev_signal),以及句柄 ev_fd。
一旦了解了事件以及相应的处理器的定义后,我们就需要去看一看如何创建这两个数据结构,并将它们插入到注册事件列表中。event 的创建可以通过定义在 event.c 中的 event_new()来创建
1 | //evsignal_new 和 evtimer_new 都是定义在 include/event2/event.h 中的宏,都是调用了 event.c 中的 event_new() 来实现 |
参考资料:
《Linux 高性能服务器编程》 —— 游双著
《libevent-book》 —— Libevent 上的官方文档
Leetcode 337. 打家劫舍 III(树形 dp)
问题描述
在上次打劫完一条街道之后和一圈房屋后,小偷又发现了一个新的可行窃的地区。这个地区只有一个入口,我们称之为“根”。 除了“根”之外,每栋房子有且只有一个“父“房子与之相连。一番侦察之后,聪明的小偷意识到“这个地方的所有房屋的排列类似于一棵二叉树”。 如果两个直接相连的房子在同一天晚上被打劫,房屋将自动报警。
计算在不触动警报的情况下,小偷一晚能够盗取的最高金额。
Example
示例 1:
输入: [3,2,3,null,3,null,1]
输出: 7
解释: 小偷一晚能够盗取的最高金额 = 3 + 3 + 1 = 7.
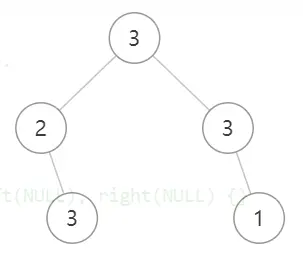
示例 2:
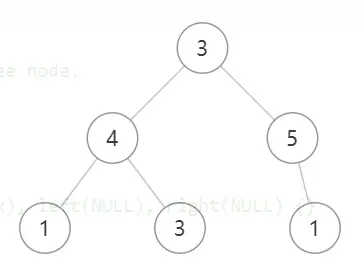
输入: [3,4,5,1,3,null,1]
输出: 9
解释: 小偷一晚能够盗取的最高金额 = 4 + 5 = 9.
题目链接: 337. 打家劫舍 III (难度:中等)
思路:
从题目上看,这显然是一个树形 dp 问题,同样还是离不开动规三要素
1、dp 定义:设 dp[root] 表示从 root 开始抢劫所能得到的最大价值
2、状态转移:
- 若不抢 root ,则 dp[root] = dp[root->left] + dp[root->right]
- 若抢 root,则 root 的左右子树均不能抢, dp[root] = dp[root->left->left] + dp[root->left->right] + dp[root->right->left] + dp[root->right->right] + root->val;
3、初态和终态
初态:dp[nullptr] = 0
终态(答案):dp[root]
由于最终答案为 dp[root],所以采用后序遍历的方式进行访问
代码
1 | /** |
执行结果: 40 ms, 25.9 MB
相关练习题:
Leetcode 213. 打家劫舍 II(动态规划,递推)
问题描述:
你是一个专业的小偷,计划偷窃沿街的房屋,每间房内都藏有一定的现金。这个地方所有的房屋都围成一圈,这意味着第一个房屋和最后一个房屋是紧挨着的。同时,相邻的房屋装有相互连通的防盗系统,如果两间相邻的房屋在同一晚上被小偷闯入,系统会自动报警。
给定一个代表每个房屋存放金额的非负整数数组,计算你在不触动警报装置的情况下,能够偷窃到的最高金额。
Example
示例 1:
输入: [2,3,2]
输出: 3
解释: 你不能先偷窃 1 号房屋(金额 = 2),然后偷窃 3 号房屋(金额 = 2), 因为他们是相邻的。
示例 2:
输入: [1,2,3,1]
输出: 4
解释: 你可以先偷窃 1 号房屋(金额 = 1),然后偷窃 3 号房屋(金额 = 3)。偷窃到的最高金额 = 1 + 3 = 4 。
题目链接:213. 打家劫舍 II (难度:中等)
思路
对于首尾的情况,一共可以分为4种
- 首尾都不偷;
- 偷首不偷尾;
- 偷尾不偷首;
- 首尾都偷;
显然由题目的描述可知,第 4 种情况会触发报警系统。因此我们需要排除第 4 种情况。另外,第 1 种情况,其实已经包含在第 2 种和第 3 种情况当中。因此我们只需要考虑第 2 种和第 3 种情况即可,可以采用两次dp,一次从0偷到n-1,一次从1偷到n,返回两次dp中的最大值即可。
动态规划三要素
dp定义:
dp[i] = x:从第 i 间房开始偷,小偷所能得到的最大金额
状态与状态转移方程:
①、第 i 间房不偷,则去第 i + 1 间房看看,dp[i] = dp[i+1]
②、第 i 间房偷,则去第 i + 2 间房看看,dp[i] = dp[i + 2] + nums[i];
方程:dp[i] = max(dp[i + 1], dp[i + 2] + nums[i]);
初态与终态
初态:dp[n] = 0
终态:dp1[0], dp2[1]
其中,dp1[i]表示从0偷到n-1号房,dp2[i]表示从1偷到n号房
代码
1 | class Solution { |
执行结果: 0 ms, 7.9 MB
缺失模块。
1、请确保node版本大于6.2
2、在博客根目录(注意不是yilia-plus根目录)执行以下命令:
npm i hexo-generator-json-content --save
3、在根目录_config.yml里添加配置:
  jsonContent:
    meta: false
    pages: false
    posts:
      title: true
      date: true
      path: true
      text: false
      raw: false
      content: false
      slug: false
      updated: false
      comments: false
      link: false
      permalink: false
      excerpt: false
      categories: false
      tags: true
主要涉及技术:
C++, 后端开发, lua语言
开源爱好者、Linux
热爱阅读,健身,旅游及美食
联系QQ:519788069
C++, 后端开发, lua语言
开源爱好者、Linux
热爱阅读,健身,旅游及美食
联系QQ:519788069